2024-2025
研发平台内专题数据库的重构设计
从平台历史遗留问题入手,通过信息重构、视觉重塑与交互定义等方法,沉淀出稳定、可拓展的数据库平台,便于未来多类业务专题库等快速落地
Context · Why this exists
理解业务与平台模式
材料研发要的不仅是再多一个数据存储柜,而是一套可持续扩展的专题数据库:让计算与实验在平台内沉淀为可检索、可对比、可复用的关键数据,支撑每一次选择与决策
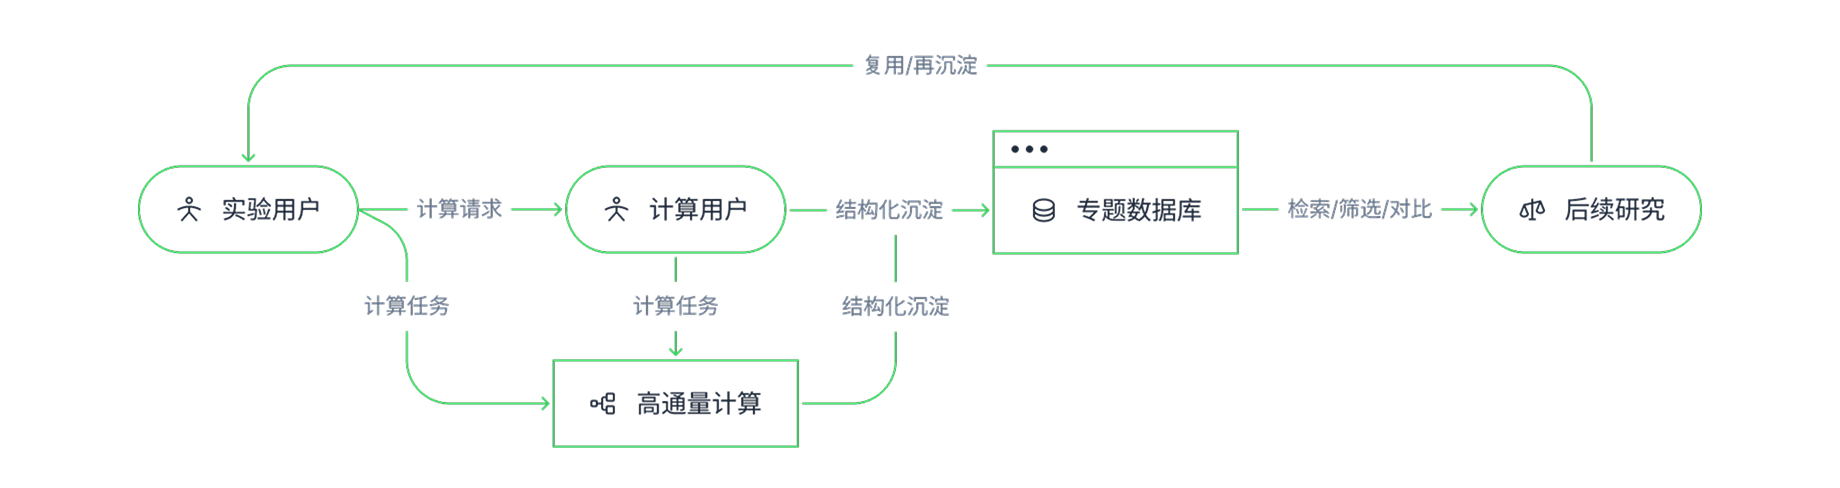
研发人员发起计算,计算任务经高通量流程产出,再结构化写入专题库,实验室的知识从个人文件变成可被复用的资产

对象
材料研发部门的研究人员:发起需求的实验人员、产出数据的计算人员

收益
研发节奏更快;实验室的知识从个人本地文件,变成可被团队复用的资产

价值
在平台内完成检索、筛选、对比,减少重复计算与试错
Challenge
历史遗留问题支撑不住决策与扩张
平台目标要成为材料研发的决策工具,但早期缺少完整规划与需求确认,多团队快速堆出的旧版无法支撑多专题库的稳定交付,且科学数据的核心问题不是展示,而是信息结构不稳定、不可靠
字段定义模糊不准:单位 / 符号 / 定义边界不清
跨页面字段不一致:同一专业概念在不同定义口径不同
复杂任务效率低:检索 / 筛选 / 对比无法在同一套语法里完成
交互规则不统一:不同数据库操作方式不统一,功能位置无规范
系统整体割裂:系统定位模糊,用户更依赖本地库
Research
How I researched
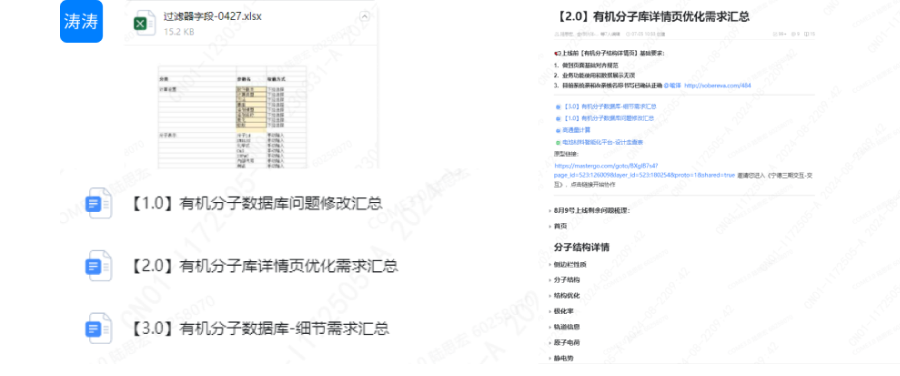
设计前期的核心工作是保证业务基础信息的无误

校准
与业务专家统一专业字段口径(单位 / 符号 / 定义边界),排查一致性
AI(Cursor)读取官方文档 + 教程 → 提炼关键信息
尽管调研产品Nomad & MP为公开数据库,定位略为不同,但是同样提供很多灵感
Research_Summary:
检索门槛需要考虑科研用户的检索习惯,而不是「每次输入完整字段」,精确查询可以为平台进阶操作
筛选过程要回答「有没有、有多少、算没算」,让用户直观决定继续收敛还是放弃
用户会在检索结果层完成初筛和对比,详情只留给深度验证
Design Goals
设计目标
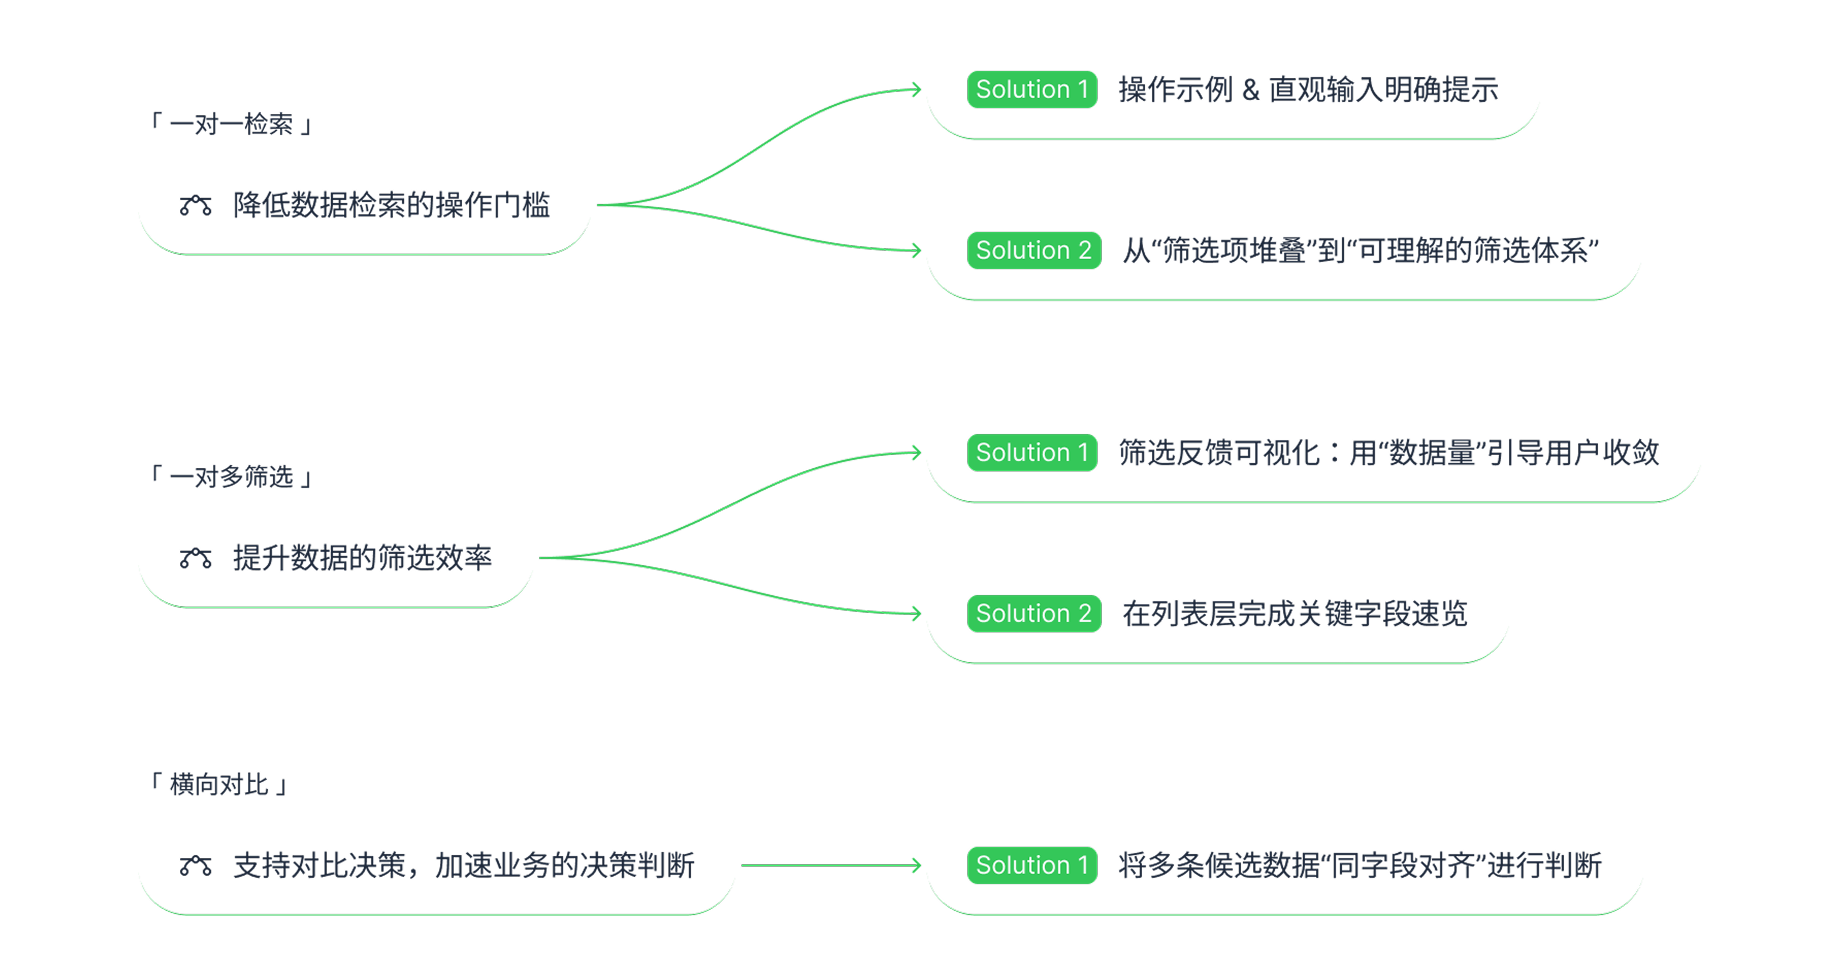
内部库的终点是复用与决策,不只是探索,因此设计目标按任务进行拆解:一对一检索、一对多筛选、横向对比
「 一对一检索 」

降低数据检索的操作门槛
Solutions 1
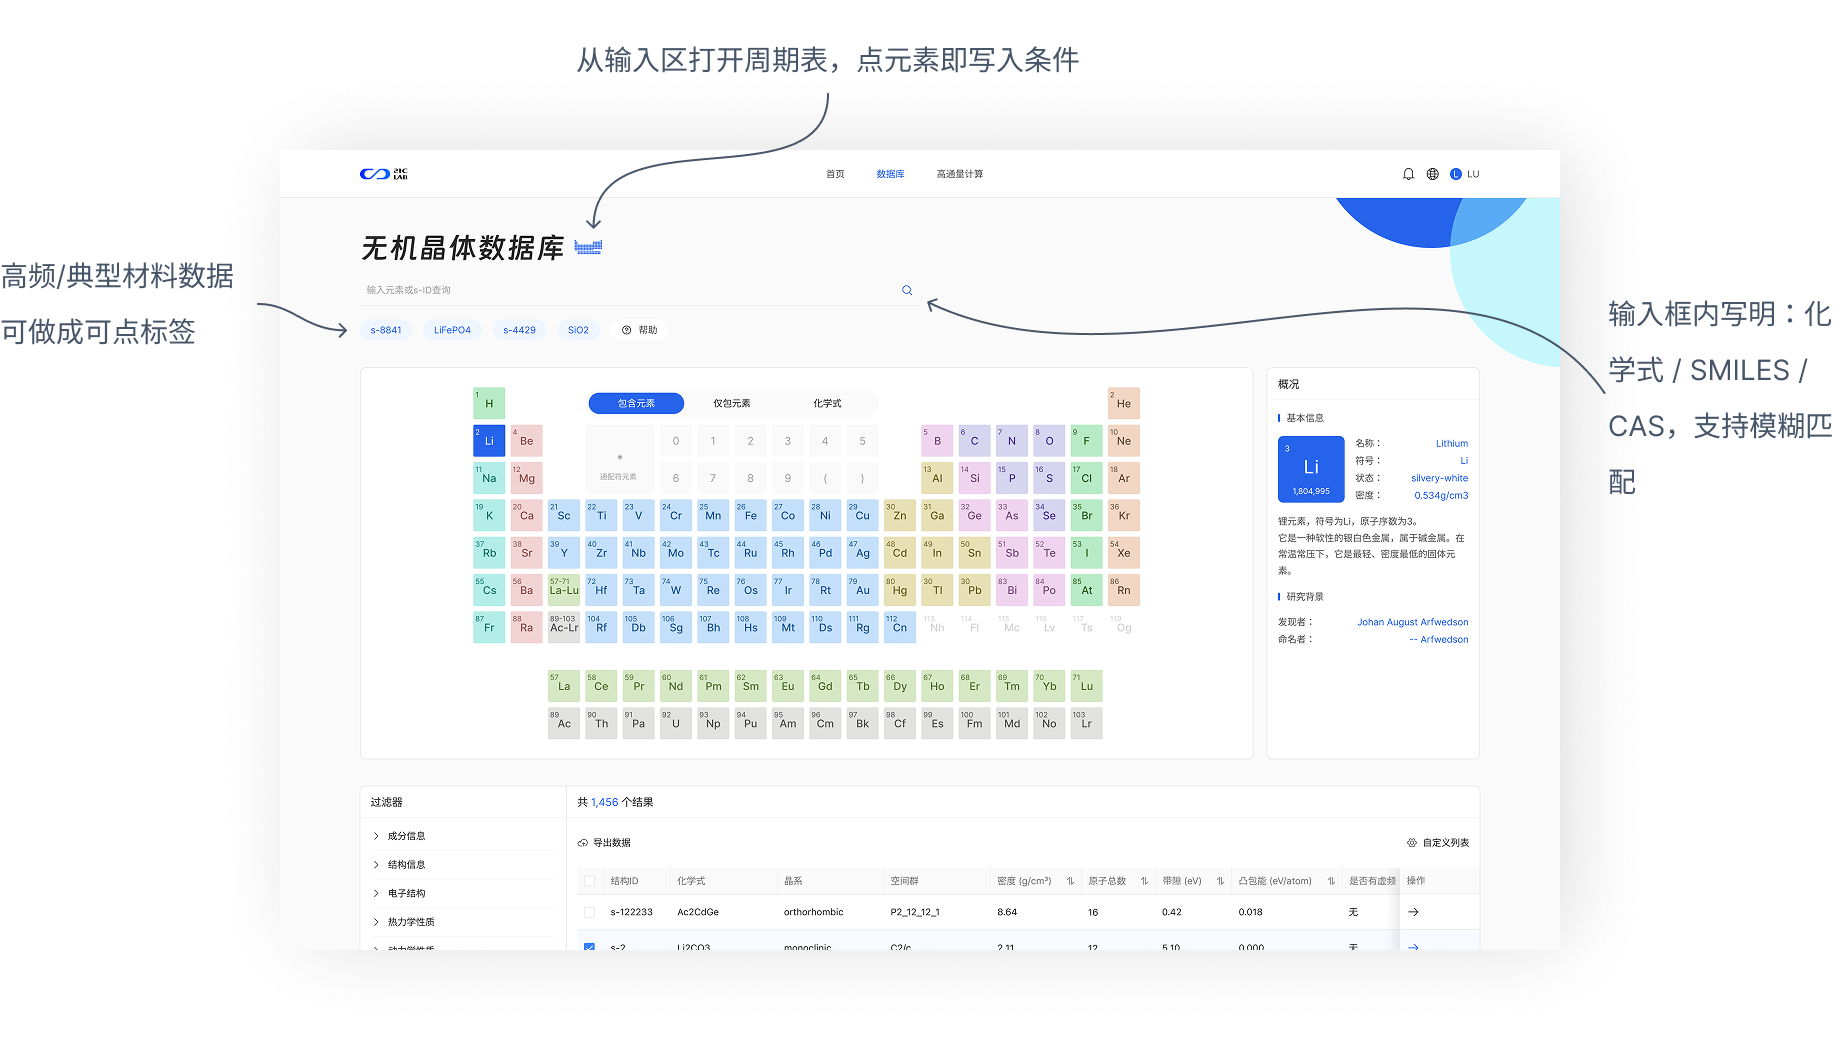
操作示例与直观输入
对比传统认知下的检索方式来说,R&D用户对数据检索有较为庞大的需求,经常看到的场景为用户仅记得部分元素或结构,不一定记得该库的完整字段或写法
「 一对一检索 」
降低数据检索的操作门槛
Solutions 2
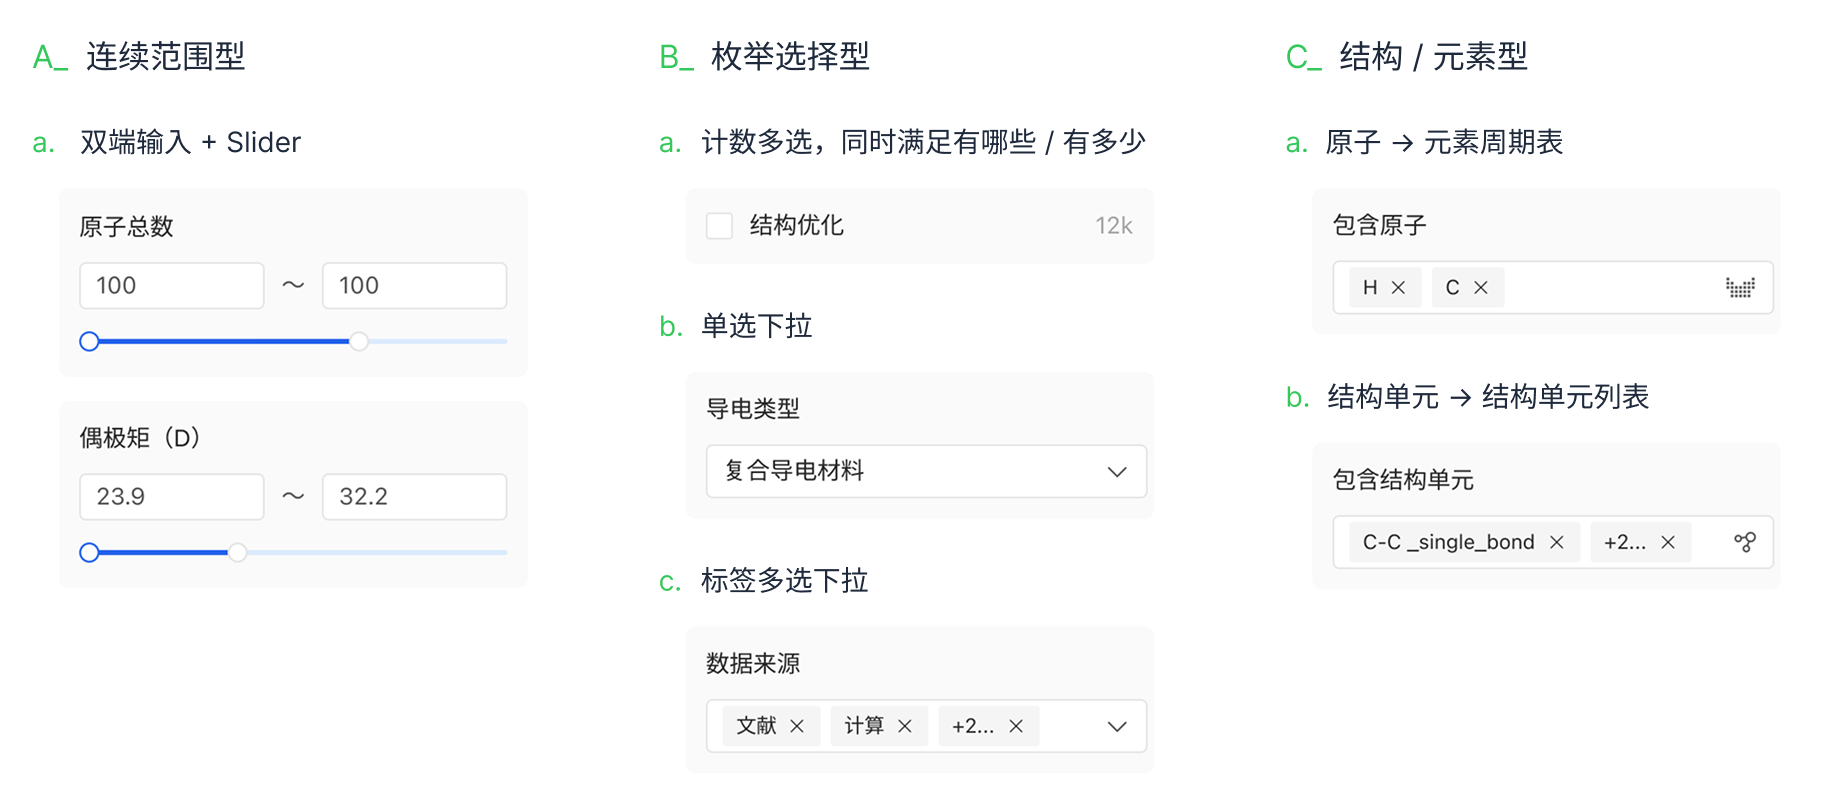
从“筛选项堆叠”到“可理解的筛选体系”
对比传统认知下的检索方式来说,R&D用户对数据检索有更 精细 的需求,用户会跨越有机、无机、专题库,通过与业务专家合作,控件形态绑定字段类型,与业务名
用户在检索场景很少一次输入即结束,而是通过筛选 → 收敛 → 再决定要比还是导出,于是对筛选功能进行迭代
「 一对多筛选 」
提升数据的筛选效率
Solutions 1
用数据量引导收敛
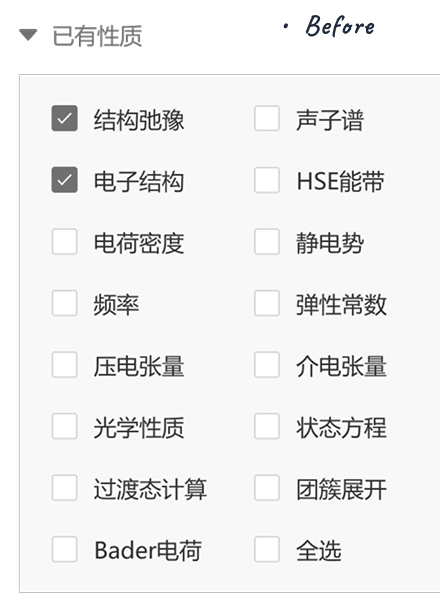
旧版将所有计算性质平铺,用户可能会面临的问题是,勾选后得到一批结果是空集
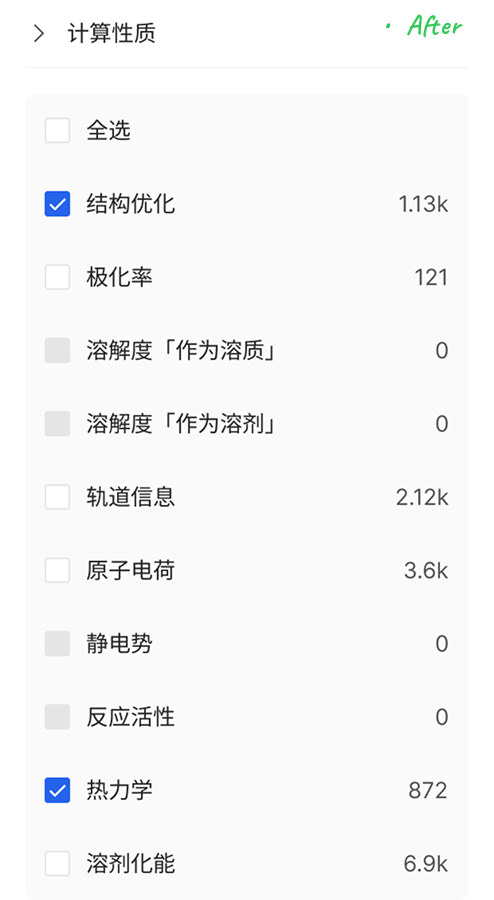
「有没有、有多少」本身是决策信息,在用户勾选之前,而不是通过结果空了知道

把“试错成本”前置降低
增加可见的数据量标识,判断数据的已计算 / 未计算
「 横向对比 」
支持对比决策,加速业务的决策判断
Solutions 1
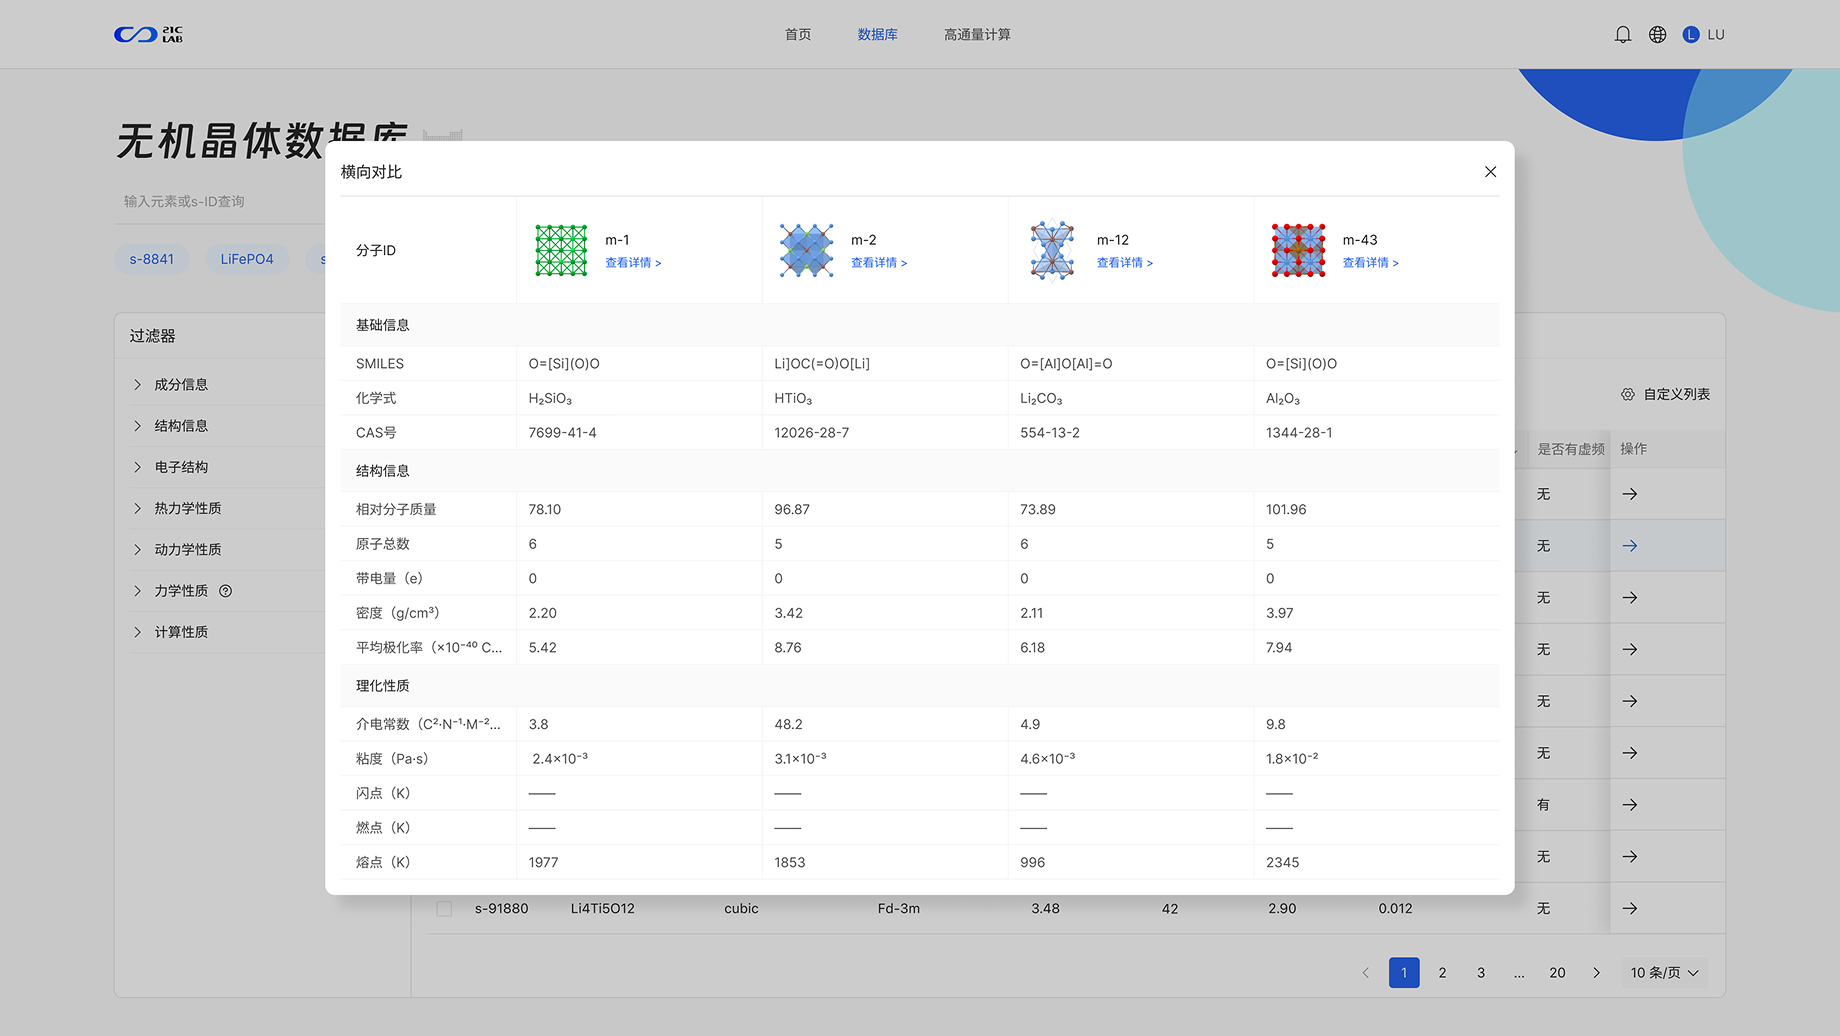
将候选数据“同字段对齐”判断
以弹窗形式将候选数据横向对齐展示,并按信息层级分组,便于用户在同一屏内快速看出差异
Design System
设计资产沉淀
通过将优先级较高的基础数据库改版落地,以更明确的标准为团队提供方向,确保所有的工作都在统一的框架内进行